以下笔记引用并借鉴了以下文章的内容,图片等:
第一季
内存布局
- 一个程序典型的内存布局如下图所示:从高地址到低地址分别为内核空间、栈、空闲区域、堆、bss、data、text。
- 栈是自顶向下增长
- 堆是自底向上增长

- 图片来自iyheart BLOG
brk(sbrk)和mmap
- 在 Linux 进程的虚拟内存空间中,
glibc的malloc作为用户态的内存分配器,其实自身并没有物理内存。当它发现内部的空闲链表不够用时,必须通过System Call向操作系统内核申请虚拟内存。 brk(包括其包装函数sbrk)和mmap就是唯二用于扩展进程虚拟内存的系统调用。brk 与 sbrk:操纵程序断点Program Break
堆的最高地址边界被称为 Program Break
int brk(void *addr);:将 Program Break 直接设置为addr指定的绝对地址void *sbrk(intptr_t increment);:将 Program Break 增加 increment 个字节。increment 为正数时扩充堆,为负数时收缩堆。
【1. 申请前】                   【2. 调用 brk(新地址) 后】

      高地址                             高地址
     +---------+                        +---------+
     |         |                        |         |
     | 未映射的 |                        | 未映射的 |
     | 空闲区域 |                        | 空闲区域 |
     |         |                        +---------+ <--- 新 brk 指针 (新堆顶)
     +---------+ <--- 原 brk 指针        |\\\\\\\\\\|
     | 堆区    |                         |\新分配的\|
     | (Heap)  |                        |\堆内存\\\|
     +---------+                        +---------+ <--- 原 brk 指针 (原堆顶)
     | .bss /  |                        | 堆区    |
     | .data   |                        | (Heap)  |
     +---------+                        +---------+
      低地址                             | .bss /  |
                                        | .data   |
                                        +---------+
                                         低地址
- 申请过程同理
mmap:创建独立的内存映射
Mmap的第一种用法是映射磁盘文件到内存中;第二种用法是匿名映射,不映射磁盘文件,而向映射区申请一块内存- Malloc使用的是
mmap的第二种用法(匿名映射) - Munmap函数用于释放内存
- 调用形式(简化):
mmap(NULL, length, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) - 它不依赖于连续的 Heap 区域,而是在虚拟内存空间中的 Memory Mapping Segment(内存映射段,通常位于堆和栈之间,动态链接库 .so 也加载于此) 中,寻找一块足够大的连续虚拟地址范围,创建一个全新的 VMA
VMA:虚拟内存
虚拟内存是操作系统内核与底层硬件(CPU 里的 MMU)联合制造的一个“内存寻址抽象层”。它让每一个运行的进程都以为自己独占了一块连续的、极其庞大的内存地址空间,而实际上,这些地址只是逻辑上的代号,它们被切成小块,散落在真实的物理内存(RAM)甚至硬盘(Swap)中
当你往虚拟内存里写入东西时,底层发生的真实情况是:你的写入指令,直接穿透了虚拟层,被硬件重定向到了真实的内存条引脚上。
所以往虚拟内存里写入的东西实际是写入的物理内存
缺页中断(Page Fault)与延迟分配:
当你 malloc(1GB) 时,系统只是在你的虚拟内存里划出了 1GB 的合法地址范围,但页表里并没有给它们分配真实的物理页(物理内存一点都没变少)。
当你的程序第一次尝试往这 1GB 的某个地址写入数据时,CPU 的 MMU 查页表发现:“哎?这个虚拟页没有对应的物理页啊!”。
此时,MMU 会立刻向 CPU 抛出一个硬件级别的异常,叫作缺页中断(Page Fault)。
操作系统内核捕获这个中断,暂停你的程序,跑去物理内存里找一页真实的空闲内存(4KB),把它清零,然后在页表里把你的虚拟地址和这块物理地址连起来。处理完后,让你的程序继续执行。你的程序完全感受不到中间发生的停顿。
- mmap()和brk()/sbrk()这两种不同方式申请的堆内存是互相独立的,各自管理不同的内存区域,使用mmap时并不会自动调整brk指针。
匿名映射:
- 创建一段没有关联任何文件
inode的VMA,这段虚拟内存完全由物理内存(RAM)或交换分区(Swap)支撑,虚拟内存有点类似于指针,往虚拟内存里写入的东西实际是写入的物理内存 - 简单来说:操作系统给你分配了一段虚拟内存,但它不和任何硬盘文件绑定。它连向的是真实的物理内存条上一块完全空白、被清零的区域
- 当程序结束或者调用 free(底层触发 munmap)时,这块内存里的数据会立刻丢失,物理内存被系统收回。它绝对不会像文件映射那样保存到硬盘上。
- 过程:
【模式一:匿名映射 (Anonymous Mapping)】
        —— 场景:malloc 申请 >128KB 的大内存

   进程虚拟内存空间                       真实的物理内存
+--------------------+               +--------------------+
|     栈 (Stack)     |               |                    |
+--------------------+               |                    |
|       ...          |               |                    |
|                    |     映射      |                    |
| [ 新增的匿名内存 ]  | ============> [   全新物理页(清零)  ]
| (纯粹的空白飞地)    |               |                    |
|                    |               |                    |
|       ...          |               |                    |
+--------------------+               |                    |
|     堆 (Heap)      |               |                    |
+--------------------+               +--------------------+
文件映射:
- 将进程虚拟地址空间中的一段
VMA(虚拟内存区域)与磁盘上某个文件的inode及物理数据块建立逻辑关联 - 简单来讲:操作系统把一段虚拟内存地址,直接和硬盘上的某个文件(比如
/lib/x86_64-linux-gnu/libc.so.6)绑死在一起连线的另一头是:硬盘上的具体文件。 - 几乎所有动态链接库(比如
libc.so)被加载到内存时,用的都是文件映射。 - 当你往这段虚拟内存里写入数据时(如果是共享映射),操作系统会在后台自动把你的修改保存到硬盘的那个文件里。
       【模式二:文件映射 (File-backed Mapping)】
        —— 场景:程序读取大文件,或加载 libc.so

   进程虚拟内存空间                       硬盘 / 文件系统
+--------------------+               +--------------------+
|     栈 (Stack)     |               |                    |
+--------------------+               |                    |
|       ...          |               |                    |
|                    |     映射      |                    |
| [ 新增的文件内存 ]  | ============> [  硬盘上的文件数据   ]
| (文件直通缓冲区)    |               | (比如 libc.so)     |
|                    |               |                    |
|       ...          |               |                    |
+--------------------+               |                    |
|     堆 (Heap)      |               |                    |
+--------------------+ +--------------------+chunk结构
chunk里面的数据:
prev_size: 如果前面一个块是空闲的,该区域表示前一个chunk的大小,如果前一个chunk不空闲,该域无意义size:当前chunk的大小,并且记录了当前chunk和前一个chunk的一些属性(记录在size的最后3个位中),包括前一个chunk是否在使用中,当前chunk是否通过mmap获得的内存,当前chunk是否属于非主分配区fd和bk:chunk处于分配状态时,从fd字段开始是用户的数据。chunk空闲时,会被添加到对应的空闲管理链表中,其字段的含义如下:fd指向下一个(非物理相邻)空闲的chunk。bk指向上一个(非物理相邻)空闲的chunk。
fd_nextsize和bk_nextsize:只有chunk空闲的时候才使用,不过其用于较大的chunk(large chunk)。- fd_nextsize 指向前一个与当前 chunk 大小不同的第一个空闲块,不包含 bin 的头指针。
- bk_nextsize 指向后一个与当前 chunk 大小不同的第一个空闲块,不包含 bin 的头指针。
- 一般空闲的 large chunk 在 fd 的遍历顺序中,按照由大到小的顺序排列。这样做可以避免在寻找合适 chunk 时挨个遍历。

图片来源:wiki.wgpsec.org
malloc_chunk&Allocated chunk&Free chunk
| 特性 | malloc_chunk | Allocated chunk | Free chunk |
|---|---|---|---|
| 概念层面 | glibc 源码中的 C 语言 struct 定义 | 运行时被程序使用的内存状态 | 运行时被系统回收的内存状态 |
| Header 占用 | 包含所有字段的定义 | 最小只占 8 字节(仅保留 size) | 至少 16 字节(包含 size + 被覆写的 fd/bk) |
| fd 和 bk 指针 | 存在于结构体定义中 | 绝对不存在(被用户数据覆盖) | 绝对存在(覆盖了用户旧数据) |
| 操作者是谁 | 编译器与底层开发者 | 你的代码(通过指针对用户数据区进行读写) | 系统内存管理器(操作 Header 和 fd/bk 维护链表) |
简单来说:
malloc_chunk:结构体定义Allocated chunk:已分配块Free chunk:已释放块
- 在
glibc的核心源码malloc/malloc.c中,堆块的结构体是这样定义的:
struct malloc_chunk {
  INTERNAL_SIZE_T      mchunk_prev_size;  /* 前一个空闲块的大小 */
  INTERNAL_SIZE_T      mchunk_size;       /* 当前块的大小 (带有 AMP 标志位) */

  struct malloc_chunk* fd;                /* 指向下一个空闲块的指针 */
  struct malloc_chunk* bk;                /* 指向前一个空闲块的指针 */

  /* 只有大型空闲块 (Large Bin) 才会用到的指针 */
  struct malloc_chunk* fd_nextsize;
  struct malloc_chunk* bk_nextsize;
};
chunk 的标志位(A/M/P 位)
在 malloc_chunk 结构体中,mchunk_size 字段不仅记录当前 chunk 的大小。由于 Linux 下堆内存分配需要按 8 字节或 16 字节对齐,size 的最低 3 个 bit 永远为 0。
glibc 利用这低 3 位作为当前 chunk 的状态标志位(从低到高依次为 P、M、A):
| 位 | 宏 / 含义 | 取值 | 语义 |
|---|---|---|---|
P | PREV_INUSE | P = 1 | 物理相邻的前一个 chunk 正在被使用(Allocated)。此时当前 chunk 的 prev_size 字段无效(可能被前一个 chunk 用作数据区)。 |
P | PREV_INUSE | P = 0 | 物理相邻的前一个 chunk 是空闲的(Free)。此时当前 chunk 的 prev_size 记录前一个空闲 chunk 的大小;堆块合并(Coalescing)依赖该位。 |
M | IS_MMAPPED | M = 1 | 当前 chunk 通过 mmap 系统调用独立分配(mmap 区域)。 |
M | IS_MMAPPED | M = 0 | 当前 chunk 属于常规 heap(由 brk / sbrk 扩展)。 |
A | NON_MAIN_ARENA | A = 0 | 当前 chunk 属于主分配区 main_arena(主线程堆)。 |
A | NON_MAIN_ARENA | A = 1 | 当前 chunk 属于非主分配区(thread arena / 子线程 arena)。 |
堆内存管理核心:main_arena 与 bins
当一个 chunk 被 free 后,为了高效复用,glibc 会将其挂载到特定的数据结构中进行管理。主线程的管理器称为 main_arena(类型为 struct malloc_state),位于 libc.so 的数据段。
main_arena 通过内部的指针数组维护多种空闲链表,这些链表统称为 bins。
空闲链表bins
ptmalloc中定义了malloc_state结构体用来统一管理bins。(而不是分别声明fast_bin、unsorted_bin),这就可以使他们在内存上是线性关系的。- 当用户使用
free函数释放掉内存,ptmalloc并不会马上将其交给操作系统,而是被ptmalloc本身的空闲链表bins管理起来。 - 这样当下次进程需要使用
malloc申请堆内存的时候,ptmalloc就会从空闲的bins上寻找一块合适大小的内存块分配给用户使用。可以避免频繁系统调用,提高程序运行效率,降低内存分配开销 malloc将相似大小的chunk用双向链表链接起来,这样的一个链表被称为一个bin。ptmalloc一共维护了128个bin(也就是说维护了128个双向链表)。每个bins都维护了大小相近的双向链表chunk。根据chunk大小分为以下几种bins:Fast binUnsorted binSmall binLarge bin
保存这些数据结构为
fastbinsY:这个数组以保存fast_binsbins: 这个数组以保存unsorted、small以及large_bins,共计可容纳126个
当用户调用
malloc的时候,能很快找到用户需要分配的内存大小是否在维护的bin上,如果在某一个bin上,就可以通过双向链表去查找合适的chunk内存块给用户使用fast_bins中的chunk,size最后一位始终置1,这是为了防止fast_bin中chunk的内存合并
+---------------------------+
|       malloc_state        |
|                           |
| +-----------------------+ |
| |       fastbinsY       | |
| | +-----+  +-----+     | |
| | | * ->|->| * ->|->...| |
| | +-----+  +-----+     | |
| +-----------------------+ |
|                           |
| +-----------------------+ |
| |     unsorted_bin      | |
| | +-----+              | |
| | | * ->|-> NULL       | |
| | +-----+              | |
| +-----------------------+ |
|                           |
| +-----------------------+ |
| |       smallbins       | |
| | +-----+  +-----+     | |
| | | * ->|->| * ->|->...| |
| | +-----+  +-----+     | |
| +-----------------------+ |
|                           |
| +-----------------------+ |
| |       largebins       | |
| | +-----+  +-----+     | |
| | | * ->|->| * ->|->...| |
| | +-----+  +-----+     | |
| +-----------------------+ |
|                           |
+---------------------------+其实就是一个邻接表(太好了,是图论,我们有救了()
1. tcache(Thread Local Cache)
- 引入版本:
glibc 2.26及以后 - 机制原理:为提升多线程分配效率,每个线程维护独立缓存结构(线程本地)
- 数据结构:单向链表(仅使用
fd指针),遵循LIFO(后进先出),头插 - 容量限制:默认支持最大
0x410字节的chunk;每种大小的链表最多存放7个chunk
安全特性:tcache操作几乎没有强校验(早期实现对double free检查不足),且分配时优先从该链表取用,是现代堆利用(tcache poisoning)的常见目标。
2. fast bins(fastbinsY)
- 物理位置:
main_arena.fastbinsY数组 - 机制原理:管理较小尺寸的空闲块(默认最大约
0x80字节)。当tcache满载或不可用时,小块可能进入此处 - 数据结构:单向链表(仅
fd指针),LIFO(后进先出)
核心逻辑(不合并机制)
- 当一个
chunk被放入fast bin时,系统不会修改其物理相邻的下一个chunk的P(PREV_INUSE)标志位(仍保持P = 1) - 因此,处于
fast bin中的chunk不会与相邻空闲chunk发生合并(Coalescing)
安全检查(典型)
- 仅检查当前放入的
chunk是否与链表头的第一个chunk相同(可防范连续double free) - 不防范交替释放:
free(A) -> free(B) -> free(A)
fast bin 链表示例(单向)
main_arena.fastbinsY[0] (size = 0x20) ---> [Chunk B] --fd--> [Chunk A] --fd--> NULL3. unsorted bin
- 物理位置:
main_arena.bins数组的第1个元素(bins[1]) - 机制原理:空闲块的“中转分拣站”。当被释放的
chunk大小超过fast bin限制且不进入tcache时,通常会先进入unsorted bin - 数据结构:双向循环链表(使用
fd与bk指针)
分拣逻辑(发生在后续 malloc)
- 当
malloc无法从tcache与fast bins满足需求时,会遍历unsorted bin - 若找到大小精确匹配的
chunk:直接分配给用户 - 若大小不匹配:将该
chunk从unsorted bin摘除,并按真实大小整理(sort)到small bins或large bins
4. small bins
- 物理位置:
main_arena.bins[2]到main_arena.bins[63] - 机制原理:管理常规大小的空闲块(通常
< 1024字节,具体以实现为准) - 数据结构:双向循环链表,遵循
FIFO(先进先出):新释放的插入头部,分配时从尾部取 - 特征:每个
small bin索引对应的链表中,chunk大小唯一且相等(例如bins[2]中只存在0x20大小的chunk)
5. large bins
- 物理位置:
main_arena.bins[64]到main_arena.bins[126] - 机制原理:管理大尺寸空闲块。由于尺寸跨度大,一个索引通常对应一个大小范围(
range) - 数据结构:双向循环链表
特征(排序机制)
- 同一
large bin内含不同大小的chunk,放入时通常按从大到小排序 - 会使用
fd_nextsize与bk_nextsize指针跳过相同大小的chunk,以加速遍历查找
堆分配(malloc)与释放(free)的宏观顺序
下述为便于理解的“宏观优先级”,不同 glibc 版本与配置可能存在细节差异。malloc(size) 寻址优先级
- 检查
tcache是否有对应大小的空闲块 - 检查
fast bins - 检查
small bins(若size符合) - 遍历
unsorted bin(并可能触发分类整理到small bins/large bins) - 检查
large bins(寻找可满足需求的最小chunk,必要时切割) - 切割
top chunk(堆区最高地址处的未分配区域) - 若
top chunk不足,触发sysmalloc(调用brk扩展top chunk,或大内存直接mmap)
free(ptr) 回收优先级
- 尝试挂入
tcache(若未满) - 若
size符合且tcache已满:头插挂入fast bins 若大于
fast bins限制:触发合并(Coalescing)逻辑- 检查物理相邻前一个块是否空闲(通过
P位),若空闲则合并 - 检查物理相邻后一个块是否空闲,若空闲且不在
fast bin中,则合并 - 将合并后的
chunk以双向链表形式挂入unsorted bin,并清除物理相邻下一个块的P位
- 检查物理相邻前一个块是否空闲(通过
第二季
- 由于上学的时候太忙碌了,没有太多时间学堆,所以学着学着弃坑了(,现在放假了,跑去公司实习,终于有时间来摸鱼学堆了(
堆基础
关于malloc_chunk的基础
- 被分配后的堆块:
struct malloc_chunk_allocated {
    size_t prev_size;   // 偏移 0x00:如果物理相邻的**上一个**块是空闲的,这里记录上一个块的大小。
                        // (注意:如果上一个块在使用中,这 8 字节会被上一个块借用存用户数据!)
    size_t size;        // 偏移 0x08:当前块的大小。最低的 3 个比特位用作标志位(如 PREV_INUSE)。
    char user_data[];   // 偏移 0x10:用户真正读写的数据区域(malloc 返回的就是这里的地址)。
};- 而其地址的排布顺序是这样的:
+-----------------------+
| 用户数据 (User Data)  |
| (比如你的结构体内容)  |
+-----------------------+ <-- malloc 返回的指针指向这里 (偏移 0x10)
| size + 标志位 (A|M|P) | <-- 记录当前块大小,最低位 P(PREV_INUSE) 记录上一个块是否在使用
+-----------------------+
| prev_size             | <-- 只有上一个块空闲时才有效;否则存的是上个块的用户数据
+-----------------------+- 空闲的堆块:
struct malloc_chunk_free {
    size_t prev_size;
    size_t size;
    /* [主体 - 原本的 user_data 区域变成了链表指针] */
    struct malloc_chunk* fd; // 偏移 0x10:Forward pointer,指向链表中的下一个空闲块
    struct malloc_chunk* bk; // 偏移 0x18:Backward pointer,指向链表中的上一个空闲块
    // (如果是 Large Bin,下面还有 fd_nextsize 和 bk_nextsize)
};- 而其地址的排布顺序是这样的:
+-----------------------+
| (未被覆盖的残留数据)  |
+-----------------------+
| bk (后向指针)         | <-- 原本存放 user_data 的地方,现在存了上一个空闲块的地址
+-----------------------+
| fd (前向指针)         | <-- 原本存放 user_data 的地方,现在存了下一个空闲块的地址
+-----------------------+ <-- (偏移 0x10)
| size + 标志位 (A|M|P) |
+-----------------------+
| prev_size             |
+-----------------------+- malloc_chunk 的源码如下:
struct malloc_chunk {
INTERNAL_SIZE_T prev_size;  /*前一个chunk的大小*/
INTERNAL_SIZE_T size;       /*当前chunk的大小*/
struct malloc_chunk * fd;   /*指向前一个释放的chunk*/
struct malloc_chunk * bk;   /*指向后一个释放的chunk*/
}
- 下面是一个经典的堆申请语句:
v3 = (const char **)malloc(0x10u);
*v3 = (const char *)malloc(size);
v3[1] = (const char *)size;- 意思是先在堆上分配一个
16字节的堆块,然后再在堆上分配一个size大小的“数据块”,并把它的地址存进刚才分配的那个块里,*v3 = (const char *)malloc(size);实际是新申请了一个空间用于存放数据,然后返回了地址值,由于v3是指向那个16字节块的指针,*v3就代表这16字节空间里的最开头8个字节。 - 在这段代码中,
*v3放到了官方结构体里 fd 的位置上,而v3[1]放到了官方结构体里bk的位置上
在 glibc 里,一个完整的堆块是从 prev_size 开始的。但 malloc 函数不会把 prev_size 的地址返回给用户。为了保护头部不被普通程序员不小心改掉,malloc 总是把跳过 16 字节头部后的地址(也就是 fd 的所在位置)返回给用户。
所以,当执行 v3 = malloc(0x10u); 时,v3 拿到的指针指向了官方结构体里的 fd。
- 于是,当申请完堆空间后,实际是这样的:
struct malloc_chunk {
    /* ------ glibc 隐藏的头部 (16 字节) ------ */
    size_t prev_size;
    size_t size;       // 值为 0x21 (因为 0x10 用户数据 + 0x10 头部 = 0x20,加标志位变成 0x21)

    /* ------ 返回给 v3 的用户空间 (16 字节) ------ */

    // v3 指向这里!所以 *v3 就是对这 8 字节赋值
    // 官方定义的 fd,现在存放了数据块的真实指针
    struct malloc_chunk* fd;   <====== 对应代码:*v3 = (const char *)malloc(size);

    // v3[1] 指向这里!(相当于 v3 加上 8 字节)
    // 官方定义的 bk,现在存放了用户输入的 size
    struct malloc_chunk* bk;   <====== 对应代码:v3[1] = (const char *)size;
};
+=======================================+
| prev_size | <-- 底层真正的 Chunk 起始地址
+---------------------------------------+
| size = 0x21 |
+=======================================+ <== v3 的指针指向这里!
| 存放着数据块的指针 (比如 0x55555577030) | <-- 原本是 fd 的位置 (*v3)
+---------------------------------------+
| 存放着具体的数字 (比如 size = 0x100) | <-- 原本是 bk 的位置 (v3[1])
+=======================================+堆块的排布
- 在
glibc中,堆的生长方向是从低地址向高地址生长的。程序最先malloc出来的内存块在最下面(低地址),后来分配的块依次往上叠(高地址),最上方则是尚未分配的广阔空间Top Chunk。 - like this:
- 图中显示的是内存中连续相邻的三个堆块:使用中(
Chunk A) -> 空闲(Chunk B) -> 使用中(Chunk C)。
【高地址】 (High Memory Addresses)
  ▲
  |   +=======================================+ <== Chunk C (使用中 / Allocated) 结束
  |   |                                       |
  |   |           Chunk C 的用户数据区        |
  |   |                                       |
  |   +---------------------------------------+
  |   | size = 0x...0 (P位=0, 记录下方块空闲) | <-- 因为 Chunk B 空闲,所以 P位=0
  |   +---------------------------------------+
  |   | prev_size = Chunk B 的大小            | <-- 指针 p (Chunk C 的头部起始位置)
  |   +=======================================+ <== Chunk B (空闲状态 / Free) 结束
  |   |                                       |
  |   |          (未使用的剩余空闲空间)       |
  |   |                                       |
  |   +---------------------------------------+ <-- 偏移 0x18
  |   | struct malloc_chunk* bk               | <-- 【官方定义】指向上一个同等大小的空闲块
  |   +---------------------------------------+ <-- 偏移 0x10
  |   | struct malloc_chunk* fd               | <-- 【官方定义】指向下一个同等大小的空闲块
  |   +---------------------------------------+ <-- 偏移 0x08
  |   | size = 0x...1 (P位=1, 记录下方块在用) | <-- 记录 Chunk B 自己的总大小
  |   +---------------------------------------+ <-- 偏移 0x00
  |   | prev_size (无效, 被 Chunk A 借用)     | <-- 指针 p (Chunk B 的头部起始位置)
  |   +=======================================+ <== Chunk A (使用中 / Allocated) 结束
  |   | [Chunk A 的用户数据最后 8 字节]       |
  |   | (强行写在了 Chunk B 的 prev_size 里)  | <-- 空间复用
  |   +---------------------------------------+
  |   |                                       |
  |   |        用户实际输入的数据内容         |
  |   |                                       |
  |   +---------------------------------------+ <-- 偏移 0x18 (原 bk 的位置)
  |   | 用户数据 (覆盖了官方定义的 bk 位置)   |
  |   +---------------------------------------+ <-- 偏移 0x10 (原 fd 的位置)
  |   | 用户数据 (覆盖了官方定义的 fd 位置)   | <-- ★ malloc 返回给程序员的地址 (mem)
  |   +---------------------------------------+ <-- 偏移 0x08
  |   | size = 0x...1 (P位=1)                 |
  |   +---------------------------------------+ <-- 偏移 0x00
  |   | prev_size                             | <-- 指针 p (Chunk A 的头部起始位置)
  |   +=======================================+ <== 堆底 (Heap Base)
  ▼
【低地址】 (Low Memory Addresses)
一个堆块的起始指针 p 永远指向 prev_size;而给到程序员的指针 mem(即 malloc 返回的值)永远指向 fd 所在的那个位置
prev_size 借用机制(会导致 Off-By-One 漏洞)
看Chunk A 和 Chunk B 的交界处。
官方结构体里确实定义了 prev_size。但是,如果当前块(Chunk B)前一个相邻的块(Chunk A)正在被使用,那么当前块的 prev_size 就是没有意义的,既然没有意义,glibc 就不会浪费 8 个字节。于是,系统允许 Chunk A 把它的用户数据一直写到 Chunk B 的 prev_size 空间里。
于是,如果往 Chunk A 写数据时,刚好发生了 1 个字节的越界写(Off-By-One),就会直接覆盖掉 Chunk B 的 size 字段最低位(P位),从而欺骗系统,造成堆块重叠(Chunk Overlapping)
Fastbin 的 LIFO 机制
- 像之前说的一样,
Bins分为很多种(Fastbin,Unsorted bin,small bin,Large bin等) 而对于
Fastbin来说,他具有以下特点:- 大小限制:专门回收比较小的
Chunk(通常小于 0x80 字节)。 - 数据结构:单向链表。它只用
fd指针,不用bk。 - 先进后出 (
LIFO):最后被free的chunk,会在下一次malloc时被最先分配出去。
-假设系统现在是干净的,链表头部指向
NULL:Head -> NULL- 1.
free(A):把A放进去,A的fd指向NULL. =>Head -> A -> NULL - 2.
free(B):把B放进去,B的fd指向当前的头部A. =>Head -> B -> A -> NULL
- 大小限制:专门回收比较小的
- 下次
malloc时,系统直接去Head取出B,然后把Head更新为B的fd(也就是A)。
double free
- 当
free掉一个堆块后,会被挂会bins链,由于Chunk处于 Free 状态时,由于User Data区域里的用户数据已经没用了,glibc会直接把这块区域拿来存放链表指针fd (Forward Pointer)和bk (Backward Pointer)。 - like this:
+-------------------------+
| prev_size (8 bytes)     |
+-------------------------+
| size (8 bytes)          |
+-------------------------+
| fd (8 bytes)            | <- 覆写了原本 User Data 的前 8 字节!指向下一个空闲 Chunk
+-------------------------+
| bk (8 bytes)            | <- 覆写了原本 User Data 的第 9-16 字节!
+-------------------------+
| 剩下的空闲空间...          |
+-------------------------+- 漏洞形成的原因是
Double Free导致链表成环 - 假设我们连续申请了两个
Chunk:A和B。
1. 释放 A
free(A);Fastbin 状态: Head -> A -> NULL
2. 释放 B
(这一步是为了绕过 glibc 的基础保护:Fastbin 不允许连续释放同一个位于头部的 Chunk)
free(B);Fastbin 状态: Head -> B -> A -> NULL
3. 再次释放 A (Double Free)
free(A);- 系统看到当前头部是
B,不是A,所以它认为A是合法的。它把A重新放到头部,并让A的fd指向当前的头部B。
Fastbin 状态: Head -> A -> B -> A -> B -> ...
- 这就是一切灾难的根源:单向链表变成了一个环形链表。
漏洞利用:指针投毒 (Fastbin Dup):
第一步:申请出成环的 Chunk
void *ptr1 = malloc(0x20); // 申请拿到了 A- 此时:
ptr1指向了A的 User Data 区域。
- Fastbin 状态更新为:
Head -> B -> A -> B...
- Fastbin 状态更新为:
第二步:篡改 fd 指针
- 此时,
A对程序来说,是“已经分配”的可用内存;但对于 Fastbin 来说,A仍然在空闲链表里(因为排在B后面) 然后通过
ptr1写入数据来篡改:*ptr1 = 0x601000; // 往 A 里写数据- 此时
A的User Data前 8 个字节,在glibc眼里正是fd指针 - 这一步写数据,在底层直接把
A的fd改成了目标地址0x601000(比如GOT表地址)。 - 此时的 Fastbin 已经被污染:
- Fastbin 状态:
Head -> B -> A -> 0x601000
第三步:拿到目标地址
malloc(0x20); // 拿到了 B。此时 Fastbin 状态:Head -> A -> 0x601000
malloc(0x20); // 拿到了 A。此时 Fastbin 状态:Head -> 0x601000
第四步:大功告成
void *target = malloc(0x20); - 系统去
Fastbin头部一看,把0x601000当作一个正常的堆块分配了给用户 - 此时
target这个指针就直接指向了系统的核心地带。往target里面写数据,就是可以覆盖系统的控制流,从而Getshell。 参考:
- https://xz.aliyun.com/news/5948
- https://d0m021ng.github.io/2017/02/24/PWN/Linux%E5%A0%86%E6%BC%8F%E6%B4%9E%E4%B9%8BDouble-free/
- https://iyheart.github.io/2024/09/11/CTFblog/PWN%E7%B3%BB%E5%88%97blog/Linux_pwn/2.%E5%A0%86%E7%B3%BB%E5%88%97/PWN%E5%A0%86double-free/
- https://www.cnblogs.com/wander-hui/p/18758784
bins链
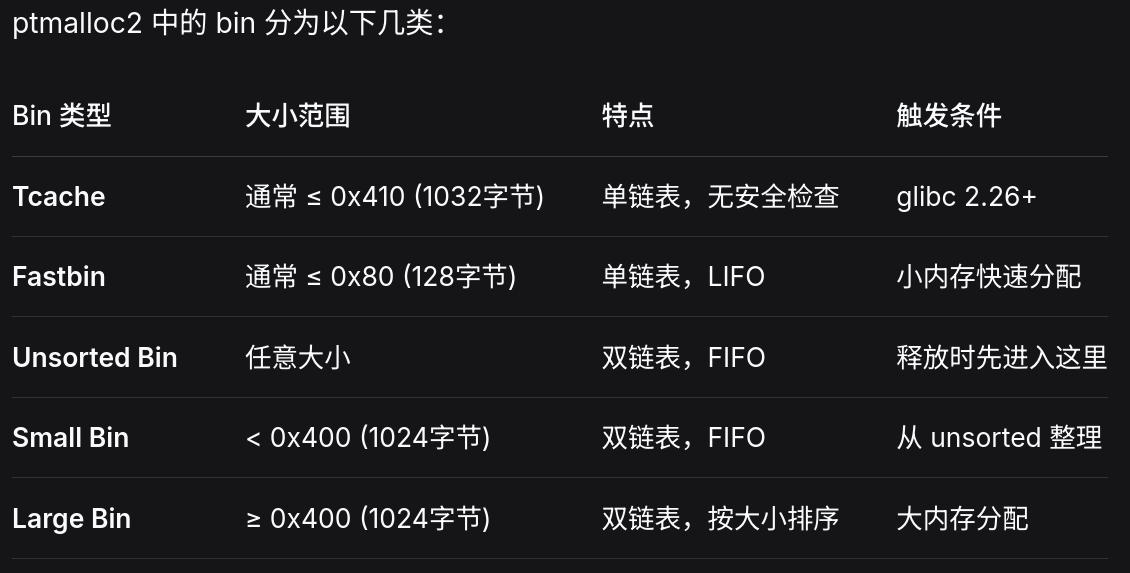
- 以上是不同的
bins链可以容纳的不同chunk大小,free掉不同大小的chunk,chunk就会被挂入不同的bin链。 **如果上一次
free掉的chunk和我这一次申请的chunk大小差不多,则会分配返回上一次free掉的那个chunk的起始地址。- 上一次
free掉的和这一次申请的大小一样:LIFO机制,很显然会返回刚刚被挂入bins链的chunk - 上一次
free掉的比这一次申请的大:会进行切割。
- 上一次
释放 chunk (0x110 含元数据)
       ↓
申请 0x90 (实际需要 0xA0 含元数据)
       ↓
从 0x110 中切出 0xA0 返回
       ↓
剩下 0x70 (0x110 - 0xA0) 成为新的空闲块- 详细过程:
* 场景:释放 0x100 字节,申请 0x90 字节
 * ========================================
 */

/*
 * 步骤 1:原始状态 - 释放的 chunk
 * ========================================
 * 地址: 0x603000
 * 用户申请: 0x100 字节
 * 实际 chunk 大小: 0x110 (含 0x10 字节元数据)
 *
 * 内存布局:
 * +------------------+ <-- 0x603000 (chunk 起始)
 * | prev_size: 0     |    (前一个 chunk 的大小,0 表示无)
 * +------------------+
 * | size: 0x111      |    (0x110 + PREV_INUSE 标志)
 * +------------------+ <-- 0x603010 (用户数据起始)
 * |                  |
 * | 用户数据区        |
 * | (0x100 字节)     |
 * |                  |
 * |                  |
 * +------------------+ <-- 0x603110 (chunk 结束)
 */

/*
 * 步骤 2:申请 malloc(0x90)
 * ========================================
 * 用户申请: 0x90 字节
 * 实际需要: 0x90 + 0x10 (元数据) = 0xA0
 * 对齐到 16 字节: 0xA0 (已是 16 的倍数)
 */

/*
 * 步骤 3:分割过程
 * ========================================
 * 从 0x110 中切出 0xA0,剩余 0x70
 *
 * 分割后内存布局:
 * +------------------+ <-- 0x603000 (原 chunk 起始)
 * | prev_size: 0     |
 * +------------------+
 * | size: 0xA1       |    (0xA0 + PREV_INUSE 标志)
 * +------------------+ <-- 0x603010 (返回给用户的指针)
 * |                  |
 * | 新 chunk 数据区   |
 * | (0x90 字节)      |
 * |                  |
 * |                  |
 * +------------------+ <-- 0x6030A0 (第一个 chunk 结束)
 * | size: 0x71       |    (0x70 + PREV_INUSE 标志)
 * +------------------+ <-- 0x6030A0 (剩余 chunk 起始)
 * |                  |
 * | 剩余空闲区        |
 * | (0x60 字节)      |
 * |                  |
 * +------------------+ <-- 0x603110 (原 chunk 结束)
*/- 剩余
chunk会根据大小而被决定放入什么bin链
- 上一次
free掉的比这一次申请的小:会查找其他bin中更大的空闲块,如果找不到,从Top Chunk切割,必要时向操作系统申请新内存。
__malloc_hook
__malloc_hook是glibc中一个全局函数指针变量,用于在调用malloc()时进行回调。
// glibc 源码中的定义
void *(*__malloc_hook)(size_t size, const void *caller) = NULL;- 位于
libc.so的数据段(.data 或 .bss 段) - 地址固定偏移(相对于 libc 基址)
- 可以通过
libc.symbols['__malloc_hook']获取 - 正常情况下,里面存的是
0x0。但是每次程序调用malloc分配内存时,系统都会先看一眼__malloc_hook,如果它是0x0:正常分配内存。如果它里面有一个地址就直接跳转去执行那个地址。
用户调用 malloc(size)
        ↓
┌───────────────────────────────────────┐
│  glibc 的 malloc() 函数入口           │
└───────────────────────────────────────┘
        ↓
┌───────────────────────────────────────┐
│  检查 __malloc_hook 是否为 NULL?     │
└───────────────────────────────────────┘
        ↓
    ┌───┴───┐
    │       │
   YES      NO
    │       │
    │       ↓
    │   ┌─────────────────────────┐
    │   │ 调用 __malloc_hook 指向  │
    │   │ 的函数                   │
    │   │ hook(size, caller)      │
    │   └─────────────────────────┘
    │       ↓
    │   ┌─────────────────────────┐
    │   │ hook 函数执行           │
    │   │ (可能是攻击者控制的代码) │
    │   └─────────────────────────┘
    │       ↓
    │   ┌─────────────────────────┐
    │   │ 返回结果给用户           │
    │   └─────────────────────────┘
    │
    ↓
┌───────────────────────────────────────┐
│  执行真正的内存分配                    │
│  __libc_malloc(size)                 │
└───────────────────────────────────────┘
        ↓
┌───────────────────────────────────────┐
│  返回分配的内存地址给用户              │
└───────────────────────────────────────┘
Top chunk
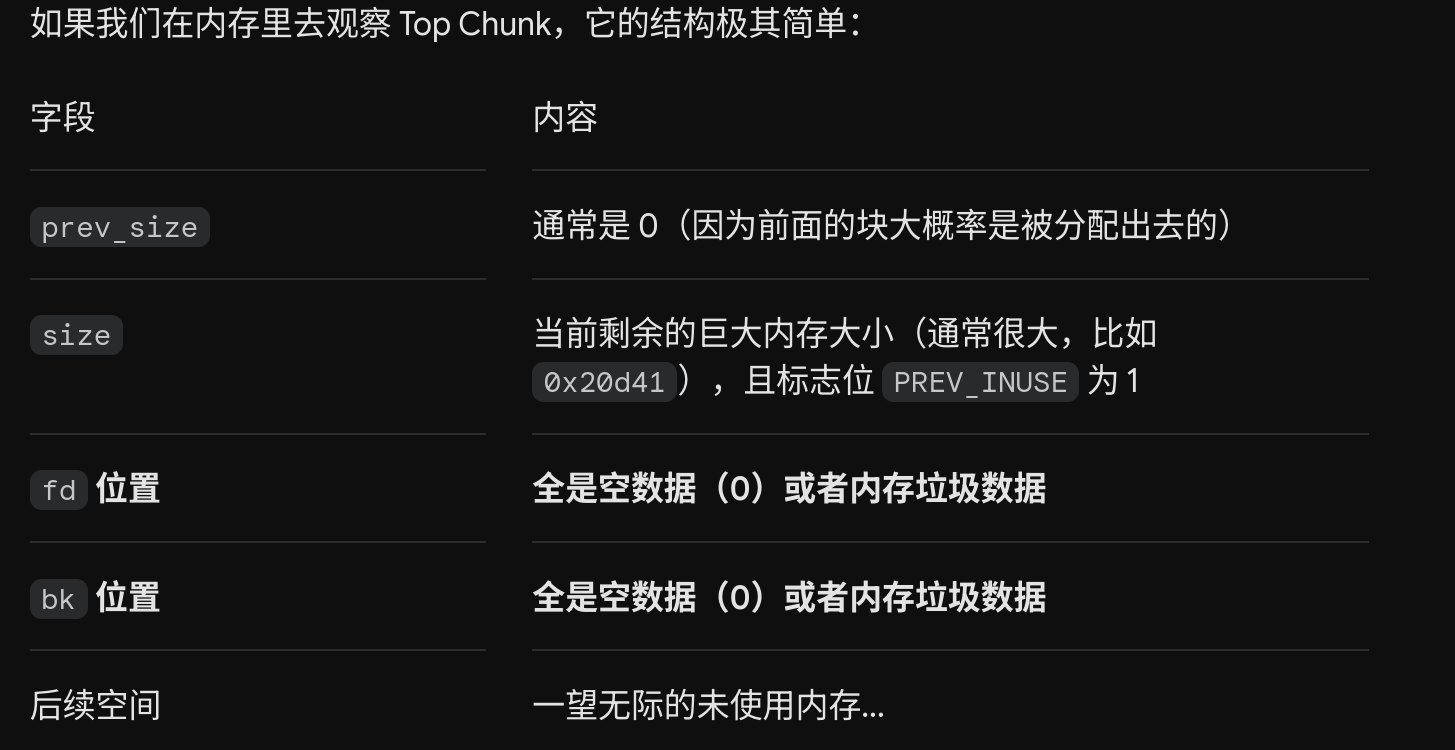
- 是位于堆内存最高地址处的一块巨大且连续的未分配内存。
- 当调用
malloc(size)申请内存时,glibc会优先去fastbin、unsortedbin、smallbins等里找有没有刚好合适的free chunk。如果都是空的,或者里面没有足够大的块能满足要求,glibc就会把从Top Chunk顶部切下需要的size作为申请而得的chunk,然后把剩下的部分更新为新的Top Chunk。 - 为了防止内存碎片化,
glibc有一个合并机制:除了进入fastbin的小块之外,任何被free的chunk如果在物理内存上与Top Chunk相邻,就会与Top Chunk合并。 - 至于为什么会与
Top Chunk相邻,可以去看看上面的堆排布部分,这也是为什么要创建隔离块。 - 在 glibc 的底层设计中:
main_arena单向记住Top Chunk,在main_arena结构体中,有一个专门的指针叫top,它记录着当前Top Chunk在堆上的起始地址。
main_arena
main_arena是一个名为malloc_state的核心结构体实例。它的主要职责就是记录当前堆内存的各种状态。main_arena里就存储着:Bins数组的头指针: 所有的fastbins、unsortedbin、smallbins、largebins的链表头尾指针,全部存放在main_arena的内部数组里。Top Chunk的地址: 记录着当前Top Chunk从哪个地址开始。- 堆的统计信息: 比如当前一共向操作系统申请了多少内存等。
main_arena是libc.so.6这个动态链接库里的一个全局静态变量(存放在.data或.bss段)。这意味着:main_arena在libc内部的偏移量(Offset)是永远固定的。只要拿到了main_arena的真实运行地址,减去它在libc里的固定偏移,就能算出libc的基址。Unsorted Bin,Small Bins,Large Bins的链表机制会自动把main_arena中当前这个bins[i]的地址写进自己Chunk的fd和bk里(关于什么是bins[i]可以看后面),而Fastbins不会。这是由数据结构决定的。这是因为它们需要维护一个双向循环链表,而链表的头地址存于main_arena。为了把链表连起来,Chunk的fd和bk必须存main_arena的地址malloc_state的`bins数组并不是这个结构体的第一个字段。在它之前,结构体中还依次存放着其他调度变量:mutex(线程锁)flags(状态标志位)fastbinsY(Fastbins的单向链表数组)top(Top Chunk的指针)last_remainder(最近一次分割后剩余chunk的指针)- 因此,要指向
bins数组,指针本身就必须带有跨越这些前置变量的物理偏移量。这也是为什么Unsorted Bin不能指向main_arena首地址,因为他们双向链表循环的建立是要建立为bins[i]<->A<->B<->bins[i]这样的,而不是指向main_arena首地址。main_arena的结构可以看前面。因此,Unsortedbins指向的main_arena+offset中的offset一般是固定的,因为它指向固定的bins[1],像Small / Large Bins那些就不是了。
glibc Bins 机制
双向循环链表(
Unsorted / Small / Large Bins)- 结构:双向循环链表,表头存在
main_arena的bins数组中([1]为Unsorted,[2-63]为Small,[64-126]为Large)。
- 结构:双向循环链表,表头存在
bins[i]实际是一个链表的头节点,内部只是存放了两个指针fd 和 bk。故无论释放了多少个 chunk,它们都会通过自身的 fd 和 bk 互相串联起来,挂在这个锚点上,形成main_arena中的具体某一个bins[i] <-> Chunk A <-> Chunk B <-> Chunk C ... <-> main_arena中的具体某一个bins[i]
Small Bins(数组下标 2-63)和 Large Bins(数组下标 64-126)之所以需要这么多数组元素,是因为它们是严格按尺寸分类的(例如 bins[2] 专放 0x20,bins[3] 专放 0x30)。而 Unsorted Bin的设计就是“不分类”。所有刚被释放的、大于 fastbin 的块,无论尺寸大小,都挂进 bins[1] 这同一条链表里。
- 指针特征:为闭合链表,唯一或首尾
chunk的fd和bk必然指向main_arena,从而留下libc地址。 Unsorted Bin中的chunk只是一个临时缓存区:当下一次调用malloc申请内存时,glibc会强制遍历这条链表,如果遇到的chunk大小恰好匹配,则直接分配给用户。如果遇到的chunk大小不匹配,glibc不会把它留在Unsorted Bin里,而是把它摘下来放入对应的Small Bins或Large Bins数组中。但不是第一次无论多大都是放进unsortedbins进入
Unsorted Bin必须同时避开情况:- 如果
chunk的大小在fastbin阈值范围内(在 glibc 2.23 中是 < 0x80 字节),free后会进Fastbins`
- 如果
- 挨着堆底的块会被
Top Chunk合并。
- 挨着堆底的块会被
- 极其巨大的块会直接还给操作系统。如果申请的内存极大(默认通常大于 128KB),
glibc当初是通过mmap直接向操作系统要的内存。free这种块时,会调用munmap直接把内存还给系统,不走堆管理器的bins机制。
- 极其巨大的块会直接还给操作系统。如果申请的内存极大(默认通常大于 128KB),
单向链表(Fastbins / Tcache)
- 结构:单向链表,按
LIFO规则运行。 - 指针特征:放入的第一个
chunk fd指向NULL,后续chunk的fd仅指向前一个chunk的起始位置,因此无需维系双向链表,故无需存main_arena。
- 结构:单向链表,按
Glibc 堆内存合并机制
- 合并发生在新块被
free但还未挂入bins链的时候,具体来说是在free()函数执行过程中的 "合并阶段",这个阶段在 "挂入链表阶段" 之前。"合并阶段"中,如果发现物理相邻的空闲块(已经在某个 bin 中),会先unlink它们,合并完成后,新的合并块作为一个整体,才被放入Unsorted Bin。
物理合并 (Consolidation)
- 针对内存地址连续的两个或多个
Chunk进行大小相加、合并为一个大Chunk的物理操作
链表解绑 (Unlink)
- 针对双向链表(
Small/Large/UnsortedBin)的指针操作 - 当一个已在链表中的空闲块需要参与物理合并时,必须先通过
unlink宏将其从当前所在的双向链表中移除,以防止合并后破坏链表结构
一、free(P) 的合并流程
- 当程序调用
free(P)释放一个不属于Fastbin大小范围的Chunk时,Glibc堆管理器会严格按照以下顺序执行:
1. 向前合并 (Backward Consolidation)
堆管理器首先检查 P 物理内存起始位置之前的 Chunk 是否空闲。
状态检查:
- 堆管理器读取
P自身Size字段的最低位(PREV_INUSE标志位)
执行逻辑:
| 条件 | 操作 |
|---|---|
PREV_INUSE == 1 | 前一个块正在使用,跳过向前合并 |
PREV_INUSE == 0 | 前一个块(记为 Prev_Chunk)是空闲的,且目前必然挂在某个双向链表中 |
合并操作:
- 读取
P头部的prev_size字段,计算出Prev_Chunk的首地址 - 调用
unlink(Prev_Chunk),将其从当前所在的双向链表中摘除 - 将合并后新
Chunk的起始地址指针,指向Prev_Chunk的首地址 - 计算新大小:
Size = Prev_Chunk->Size + P->Size
2. 向后合并 (Forward Consolidation)
处理完前驱块后,堆管理器继续检查物理内存紧随其后的 Chunk 是否空闲。
定位后驱块:
- 使用
P的首地址加上P->Size,定位到下一个物理相邻块(记为Next_Chunk)
状态检查:
- 读取
Next_Chunk的下一个物理相邻块的PREV_INUSE标志位
执行逻辑:
| 条件 | 操作 |
|---|---|
| 标志位为 1 | Next_Chunk 正在使用,跳过向后合并 |
| 标志位为 0 | Next_Chunk 是空闲的,且挂在双向链表中(Top Chunk 除外) |
合并操作:
判断
Next_Chunk是否为TopChunk- 如果是:直接将当前合并块与
TopChunk融合,更新TopChunk的首地址和大小,流程结束 - 如果不是:调用
unlink(Next_Chunk)将其从当前双向链表中摘除
- 如果是:直接将当前合并块与
- 计算新大小:
Size = Size + Next_Chunk->Size
3. 更新元数据并挂入链表 (Relinking)
如果合并后的 Chunk 没有并入 Top Chunk,堆管理器需要将其作为一个完整的空闲块重新处理。
更新自身元数据:
- 将步骤 1 和 2 计算得出的最终
Size写入这个合并块的Size字段
更新相邻块元数据:
- 找到合并块物理位置后的下一个
Chunk,将其prev_size字段更新为合并块的总大小 - 将其
Size字段的PREV_INUSE标志位清零
插入新链表:
- 将这个最终生成的合并块,统一插入到
UnsortedBin的双向链表头部
二、特殊情况补充
Fastbin的不合并机制
机制描述:
- 当释放的
Chunk属于Fastbin范围(通常为0x20 - 0x80)时,上述合并流程被强制旁路
处理方式:
- 堆管理器直接将该
Chunk插入对应的Fastbin单向链表头部 - 物理相邻的下一个
Chunk的PREV_INUSE标志位保持为 1,系统视其为仍在使用的状态,从而避免合并
后续处理:
- 当系统触发
malloc_consolidate()(如分配大内存或malloc_trim)时,会将Fastbin中的Chunk逐一取出 - 清除其
PREV_INUSE假象,并严格按照上述的向前/向后合并流程进行处理,最终归入UnsortedBin
- 堆布局中的隔离机制 (
Guard Chunk)
机制描述:
- 在漏洞利用或实际程序分配中,如果两个相同大小的
Chunk在物理内存中被一个处于 "使用中" 状态的Chunk隔开,物理合并的条件将无法满足
实际表现:
- 释放这两个
Chunk时,它们会分别独立走完释放流程 - 最终作为独立的节点挂入同一个
Bin链表中(例如SmallBin或UnsortedBin) - 这就形成了逻辑上相连、物理上分散的内存布局
堆保护机制
- 通常称为堆完整性检查,有以下几种:
链表完整性检查 (
Link Integrity Checks) - 验证指针是不是被篡改了。Safe Unlinking(安全卸载):防御的是双向链表的fd和bk被恶意篡改。是Glibc历史上最著名的一次安全升级(约在 2004 年加入),结束了上古时代最泛滥的“Unlink任意地址写”攻击。Fastbin Double Free检查:当你连续两次free同一个Fastbin块时,系统会检查链表头部的那个块是不是你现在要释放的这个。如果是,直接报错double freeorcorruption(fasttop)。防止把同一个块两次挂进链表,造成环形引用。
内存块元数据检查 (
Chunk Metadata Checks) - 验证这个块有没有被造假。Fastbin Size检查:提取伪造块的Size,算索引看匹不匹配。防止用假地址骗内存,也就是防针对fd指向的任意写。Next Size检查:在释放一个块或者合并块的时候,系统有时会顺便看一眼下一个物理相邻块的Size,看看它的大小是否合法。Top Chunk完整性检查:Top Chunk的Size必须是合法的,且必须包含某些特定的标志位。如果不小心覆盖了Top Chunk的Size把它改小了,下一次分配内存时系统就会崩溃。
指针级加密保护 (
Pointer Protection) -Glibc 2.32以后引入Safe-Linking(安全链接):对于Glibc2.32 及以上的版本,Fastbin Attack无效。因为开发者在fd指针里加入了异或加密机制。fd里存的不再是明文地址,而是地址 ^ (自身地址 >> 12)。
Safe Unlinking
- 针对
Small Bin、Large Bin和Unsorted Bin的指针篡改。它的触发时机通常是在free()发生时,系统试图将相邻的两个空闲块合并,需要把其中一个块从双向链表中摘除(Unlink),也就是上文链表解绑时。
触发场景:当系统准备把堆块 P 从双向链表中摘出来时。流程
1. 抓取前后驱指针
- 读取它的前驱指针
FD = P->fd和后驱指针BK = P->bk。
2. 前向交叉验证
if (FD->bk != P)则报corrupted double-linked list
3. 后向交叉验证
if (BK->fd != P)则报corrupted double-linked list
4.放行
- 只有当两边都不符合时才
FD->bk = BK;BK->fd = FD;
Fake Unlink:
假设你有一个已知地址的全局变量 ptr 指向 P,你就把 P->fd 设为 &ptr - 0x18,把 P->bk 设为 &ptr - 0x10。这样系统去验证时,读取到的恰好是 ptr 里的 P 的地址,能骗过交叉验证,实现 ptr = &ptr - 0x18 的劫持
Fastbin Double Free Check
- Fastbin 因为是单向链表,没有
bk指针,所以做不了 Safe Unlink。但为了防止“连续释放同一个块”导致链表成环,Glibc 加入了这个检查。
触发场景:当你调用free(P),且P的大小属于 Fastbin 范围时。
执行流程
- 定位归属链表
系统读取正在释放的块P的Size,计算出它应该进入哪个 Fastbin 数组(例如大小为0x70会定位到fastbins[5])。 - 提取链表头部
系统去fastbins[5]的数组格子里看一眼,找出目前排在链表最开头的那个 Chunk 的地址,将其记作Old_Top。 - 比对顶部指针
看看当前要释放的p是否等于Old_Top(if (P == Old_Top)) - 判决
如果相等:说明刚刚释放了P,现在紧接着又要释放P。报错double free or corruption (fasttop)并引发崩溃。
如果不相等:验证通过,系统将P塞进链表,使其成为新的 Top。
ABA 攻击:
先 free(A)(此时头部是 A);
再 free(B)(此时头部是 B,检查 A!=B,放行);
再 free(A)(此时头部是 B,检查 A!=B,放行)。
这样,同一个 A 被挂入链表两次,造出Fastbin 环
Fastbin Size Check
触发时机:当程序调用malloc(size),且系统计算出该size属于 Fastbin 范围时,堆管理器会前往对应的 Fastbin 链表,准备将链表头部的 Chunk 分配给用户。
- 在真正移交头指针之前,系统执行 Size 检查。
流程
- 抓取目标内存块
- 动作:堆管理器读取当前 Fastbin 链表头部存放的指针(无论这个指针是合法的,还是被篡改的 Fake 目标)。
- 状态:系统将该指针强行转换为一个 Chunk 结构体指针
P,并认为P就是这个内存块的绝对起始地址。 - 读取原始 Size 字段
- 定位:系统跨过 Chunk 头部前 8 个字节的
prev_size字段。 - 读取:直接读取
P + 8位置的 8 个字节(在 64 位系统中),将其作为该 Chunk 的原始Size数据提取出来。 - 去除标志位,提取纯净大小
- 机制描述:Chunk 的
Size字段的最低 3 个比特位(Bit 0, 1, 2)并不表示大小,而是分别代表PREV_INUSE (P)、IS_MMAPPED (M)和NON_MAIN_ARENA (N)标志位。 - 底层操作:源码调用
chunksize(P)宏,本质上是执行一个位掩码(Bitwise AND)操作:Raw_Size & ~0x7。 - 结果:强制将最后 3 位清零,得出这个块的“纯净物理大小”(Physical Size)。
- 示例:如果读取到的原始数据是
0x7f(二进制0111 1111),清零后三位后,计算出的纯净大小为0x78(二进制0111 1000)。 - 计算 Chunk 所在索引
- 机制描述:系统需要知道,这个读取出来的纯净大小,究竟应该属于 Fastbin 数组里的哪一个格子(Index)。
- 底层操作:源码调用
fastbin_index(sz)宏。在 64 位系统中,核心算法是将纯净大小右移 4 位,然后减 2。 - 结果:得出一个整型的索引值。
- 示例:纯净大小
0x78右移 4 位变为7,7 - 2 = 5,即索引为5。 - 预期索引验证
- 提取预期索引:系统核对本次
malloc请求。例如用户申请的是0x60的数据空间,加上0x10头部,系统预期需要一个大小为0x70的 Chunk。系统将0x70代入同样的公式(0x70 >> 4 - 2),算出预期索引为5。 比对:
if (实际计算索引 == 预期索引)**:检查通过,系统认为该 Chunk 合法,将其从单向链表中弹出,交接给用户。if (实际计算索引 != 预期索引)**:检查失败,系统触发安全异常,抛出malloc(): memory corruption (fast)错误并终止程序。
错位伪造:
由于 Fastbin Size Check 依赖于右移 4 位的运算,这在二进制层面抹平了部分数值差异,导致了致命的错位伪造漏洞:
在 64 位环境下,大小为 0x70(二进制 0111 0000)和大小为 0x78(二进制 0111 1000)的 Chunk,在右移 4 位后,得出的数值完全相等(均为 0111,即 7)。
利用:攻击者在内存中寻找包含 0x7f(如 libc 中的某些地址高位)的字节,通过将 fd 错位指向该字节之前。
堆管理器读取到 0x7f,去除标志位后得到 0x78,计算出的索引与 0x70 的预期索引一致。至此,即可骗过分配器,将系统指针(如 __malloc_hook)的内存区域申请出来。
Next Chunk Sentinel
- 用于防范堆溢出攻击
Safe-Linking
触发场景: 把块放入单向链表(写fd时),或从单向链表拿出块(读fd时)。
执行流程
- 获取随机掩码
- 系统并不需要生成密钥,它直接利用了 ASLR 机制。
- 它取当前内存块自身的地址,将其向右移 12 位(
Address >> 12)。 - 因为 ASLR 每次运行时的堆基址都在变,所以这个右移后的值每次都是一个不可预测的随机密钥。
- 加密写入
- 当系统要把块
P的fd指针指向下一个空闲块Next时: - 底层操作:不再存储明文的
Next地址,而是存储(P >> 12) ^ Next(即右移后的地址与 Next 进行 XOR 异或运算)。 - 现象:你在内存里用 GDB 查看此时的
fd,看到的是乱码 - 解密读取
- 当系统要把
P分配给你,需要顺着fd去找下一个空闲块时: - 底层操作:取出那串乱码,将其与
(P >> 12)再次进行一次 XOR 异或运算。 - 原理:利用异或运算的自反特性(
A ^ B ^ B = A),系统还原出Next地址。
漏洞泄露堆基址:
拿到了堆基址,就可以算出 (P >> 12) 这个掩码。然后在伪造 fd(比如想指向 __malloc_hook)的时候,用 Python 在脚本里手动做一次异或:payload = p64(target_addr ^ (heap_base >> 12))。把加密后的假指针写进去,系统解密时,就会还原成想要的 target_addr


评论已关闭